ホームパーソナリティ状況判断推論開発の進め方プラットフォーム研究キャリアガイダンスお問い合わせ
Miraai 状況判断

貴社の職務のシーンで、候補者が何をするかを採点。

難しいお客様、うまくいかないシフト、誰かに決断がのしかかる瞬間など、貴社の社員自身が語った状況から短いシーンを作ります。候補者はその場にいる視点でシーンを見てから対応の選択肢を評価するため、入社を承諾する前に仕事の実際を知ることができ、貴社は採用する前に候補者がどう対処するかを見ることができます。

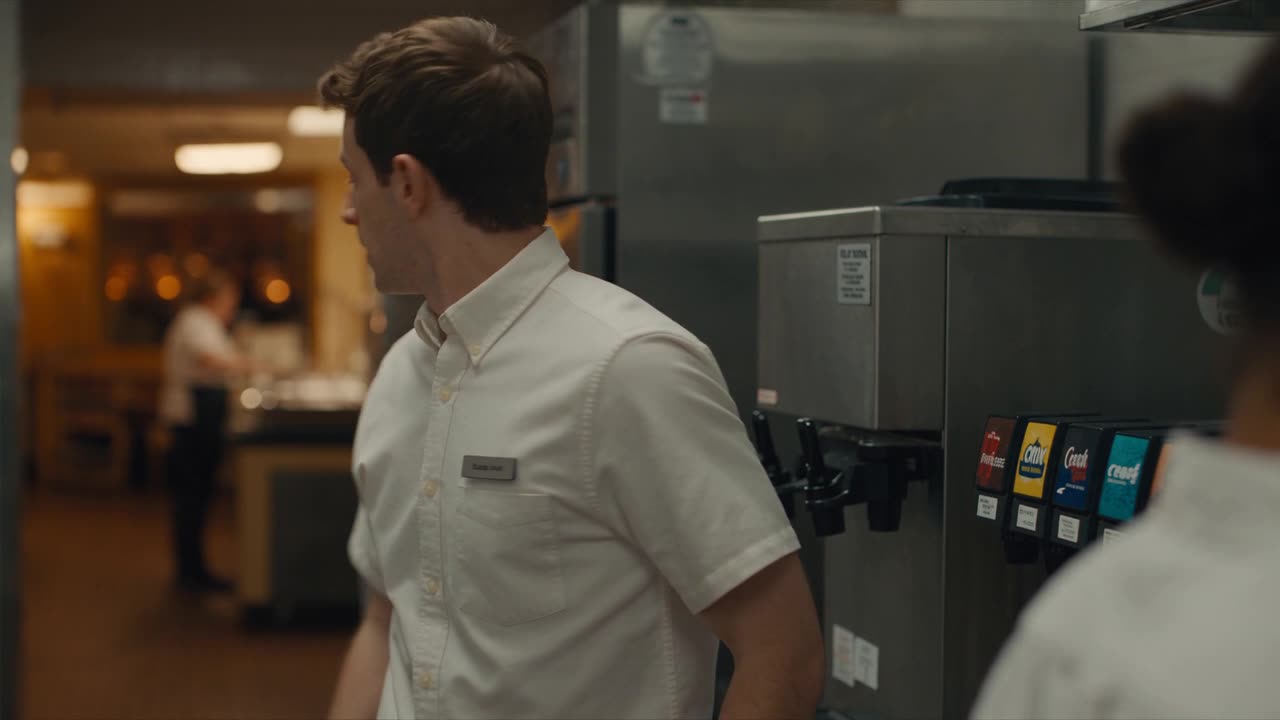
レストランホールスタッフ
あらゆる職務、あらゆる業界

貴社の社員が働く場所を舞台に。

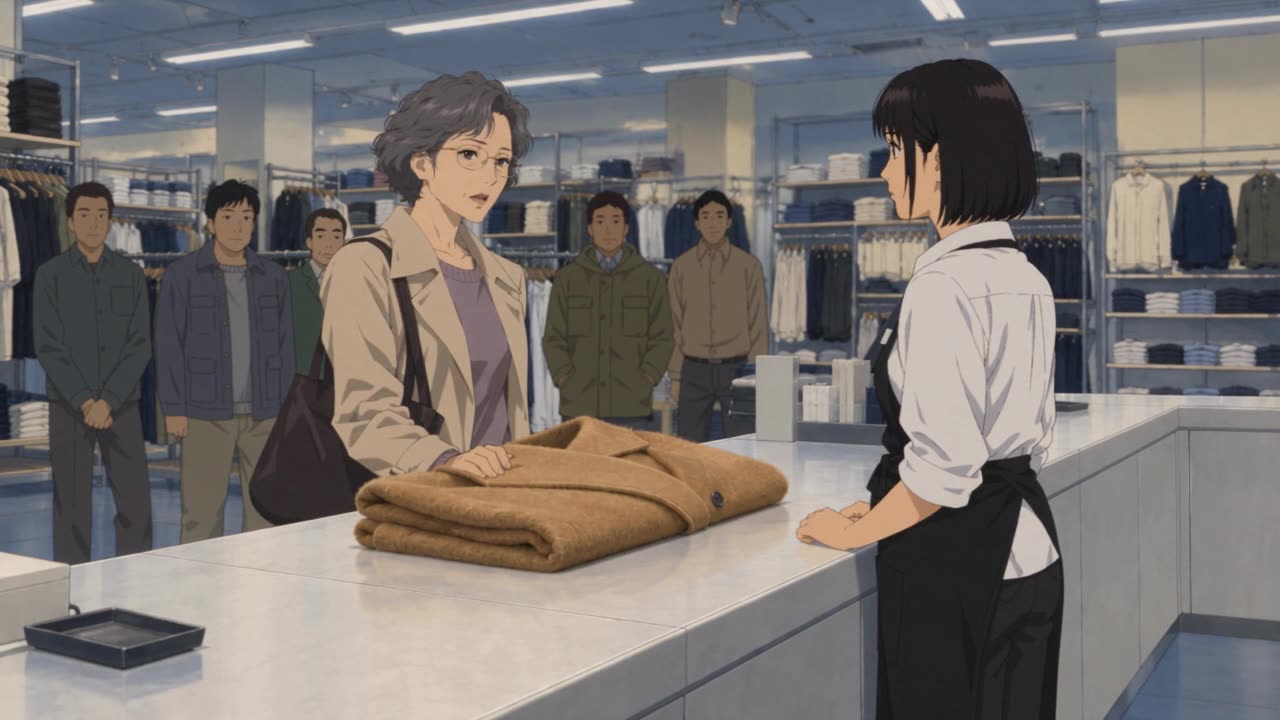
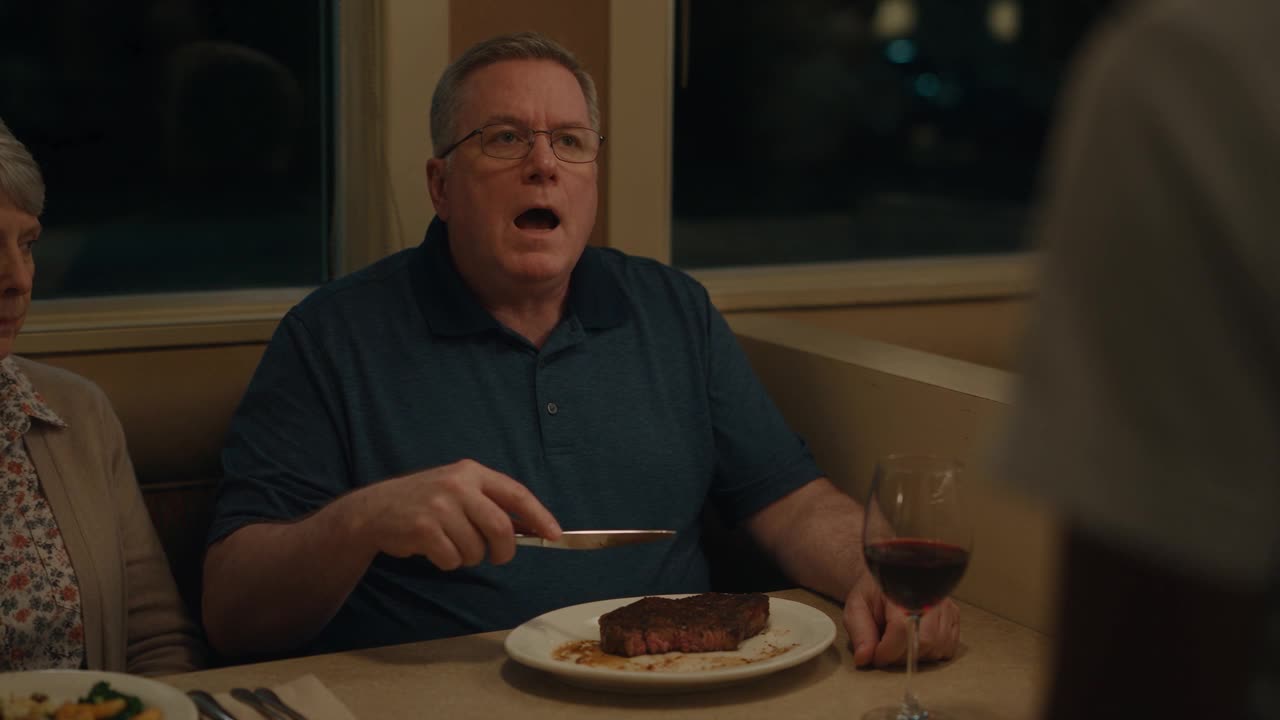
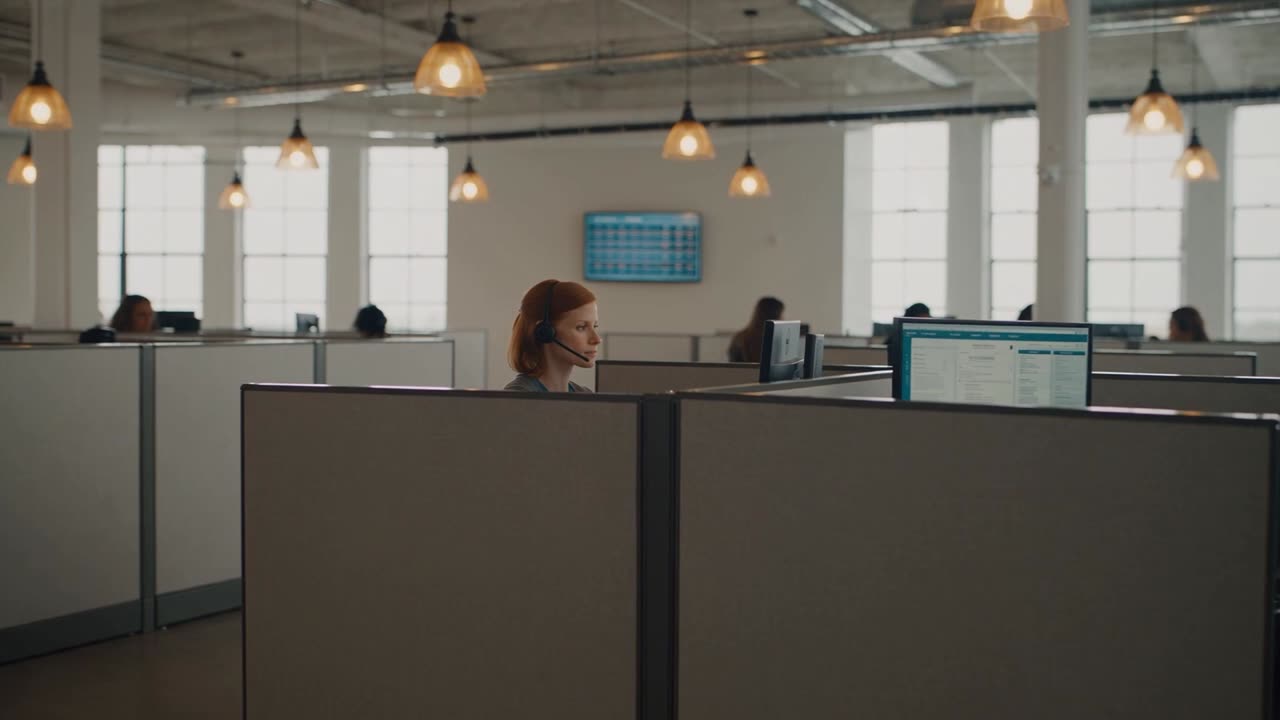
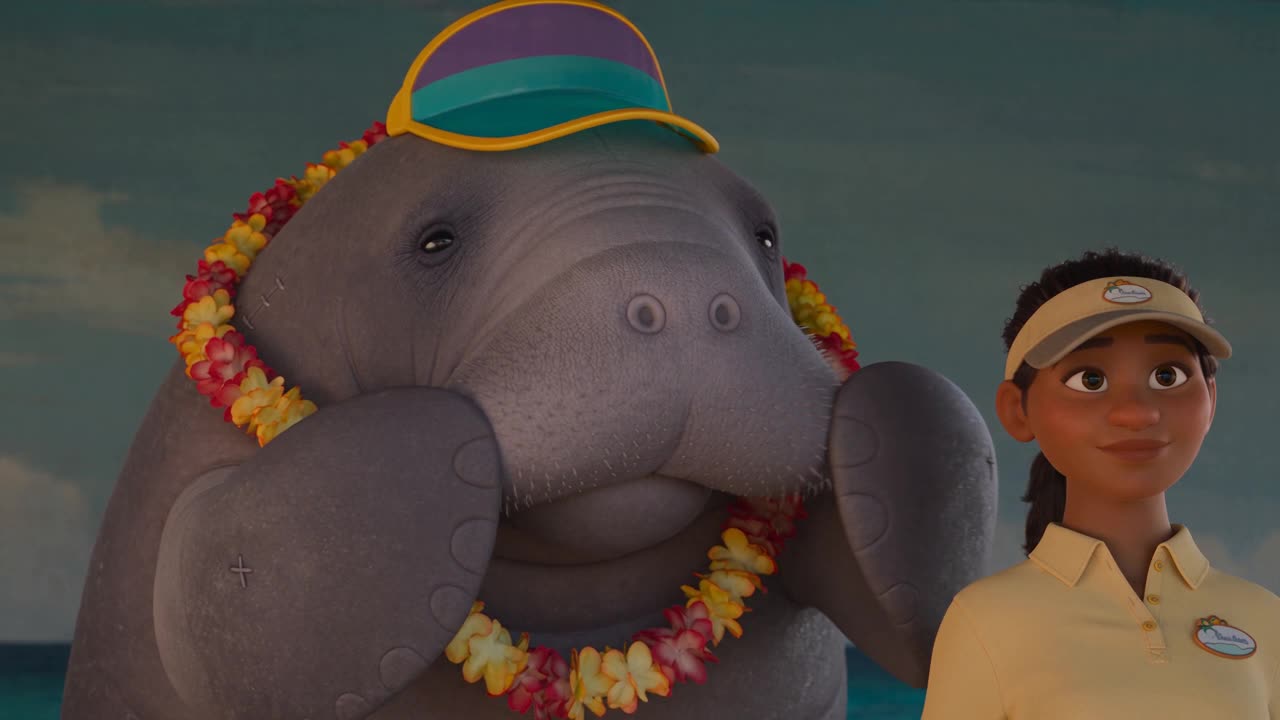
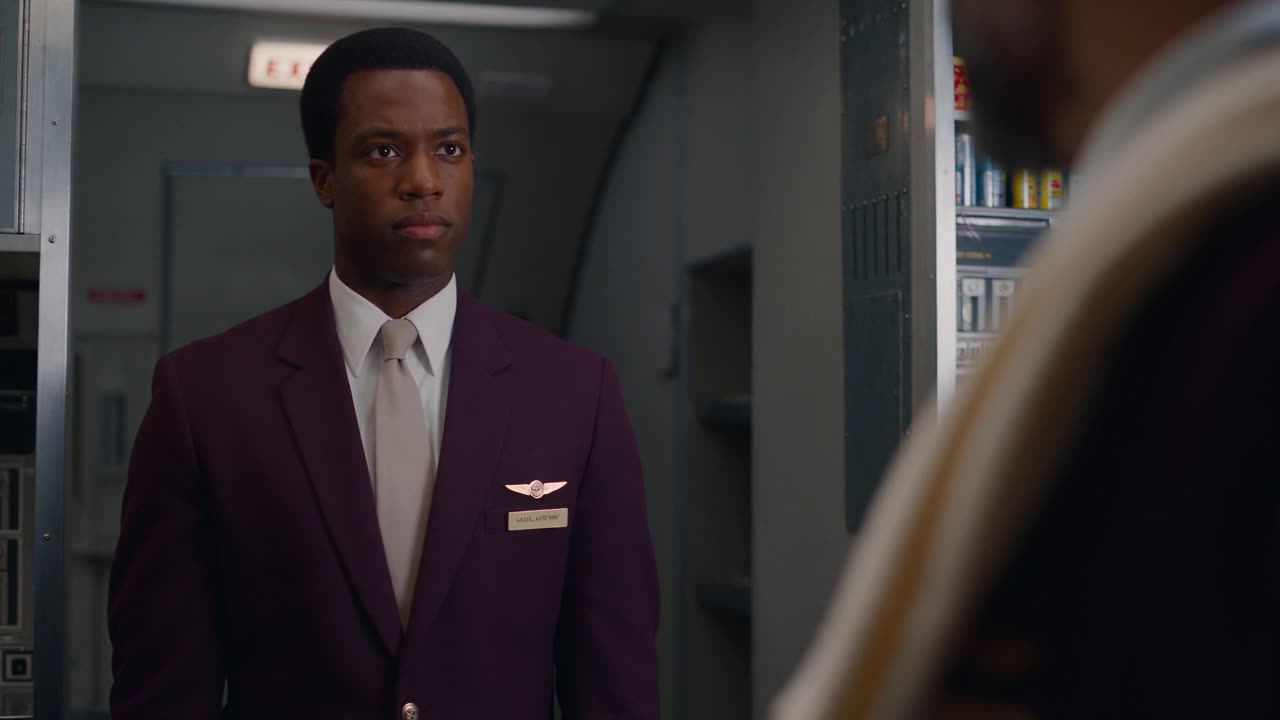
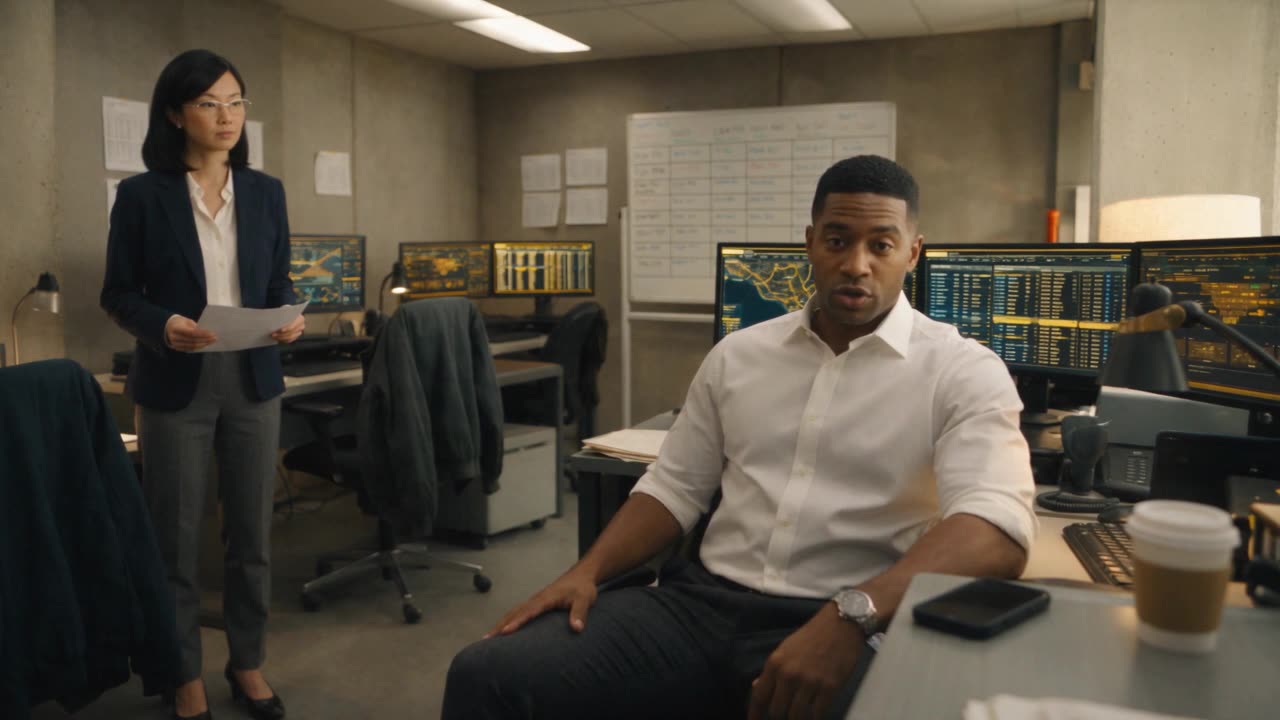
シーンは実写でもアニメーションでも、どんな舞台設定でもどんな言語でも制作でき、シーンの作り方がどうであれ、判断、対応の選択肢、採点は同じままです。以下は小売、レストラン、コンタクトセンター、テーマパーク、航空会社、リーダーシップの例です。

小売販売スタッフ
レストランホールスタッフ
コンタクトセンターカスタマーサービス
リゾート・テーマパークゲスト対応スタッフ
航空会社客室乗務員
リーダーシップマネージャーとチームリーダー

すべての登場人物は制作前に文章で記述されて承認を受け、その記述がその人物の登場するすべてのフレームの基になるため、候補者が最初のシーンで出会う人物は、最後のシーンで出会う人物と同じです。

候補者が回答する流れ

シーンを見て、対応の選択肢を評価する。

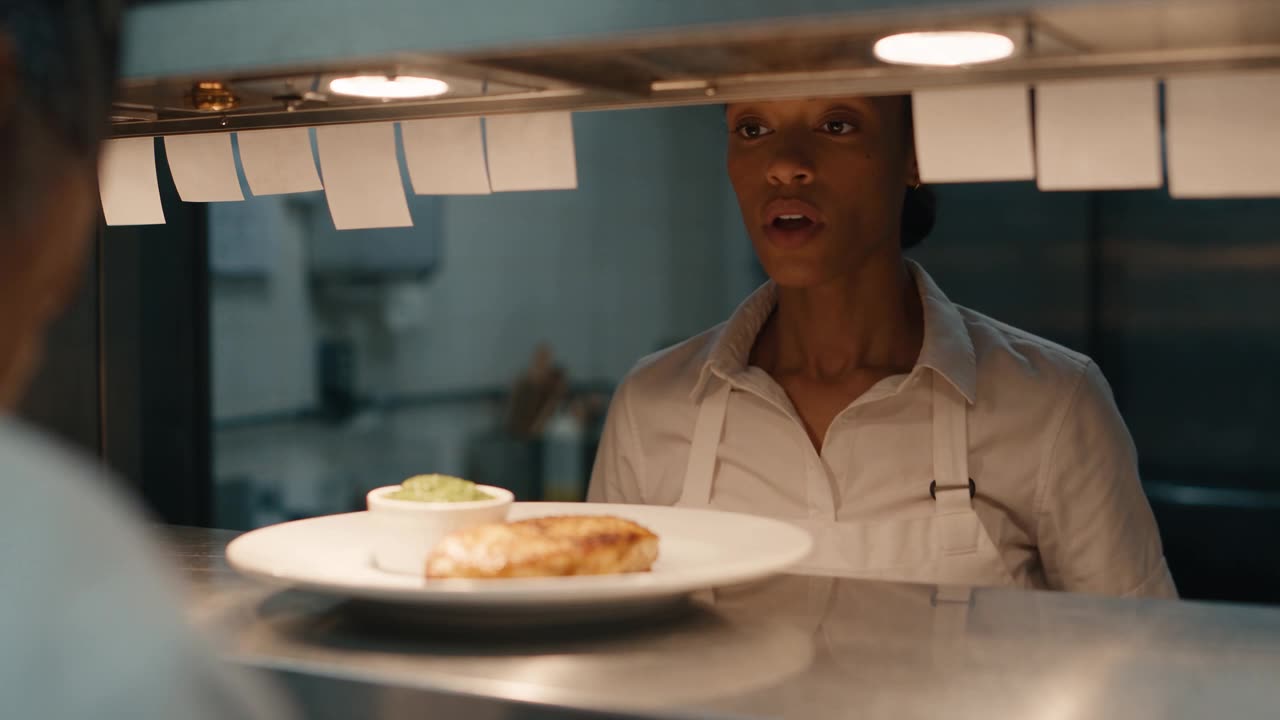
金曜の夜、ホールスタッフが子どもの木の実(ツリーナッツ)アレルギーを知らされたところで、調理担当は料理をすぐに出したがっています。シーンの後、候補者は考えられる対応を一つずつ順に評価します。候補者のスコアは、各シーンの対応の選択肢をどう評価したかのみから算出されます。声に出して答えることはテストに含まれません。以下のデモは無音で、字幕付きです。

アニメーションによるデモです。ホールスタッフが、担当テーブルの子どもに木の実アレルギーがあることを知ります。調理担当は、皿からペストソースを外してそのまま出すように言います。その後、候補者は4つの対応の選択肢を一つずつ評価します。

エビデンス

研究が示すあるべき方法で採点される状況判断テスト。

スコアがどのように算出されるか、採点キー研究で何がわかったか、そしてこの方法で構築されたテストについて公表済みの研究が何を示しているか。

回答の採点方法

評価された対応の選択肢は、貴社の専門家が設定した採点キーに照らして採点され、専門家の意見の一致度で重み付けされます。候補者のスコアは、各シーンの対応の選択肢をどう評価したかのみから算出されます。声に出して答えることはテストに含まれません。候補者の採点、順位付け、不合格の判定をAIモデルが行うことはありません。シーンによって状況が固定されているため、候補者の経歴や経験が判断の対象になることはありません。

候補者は職務プロファイルと比較され、自動的に不合格になる人はいません。 AIが使われる場面

採点キーの設定方法と、専門家パネルとの照合

AI評価者パネルが採点キーの草案を作る前に、その評価は人間のパネルと照らし合わせて測定されました。専門家パネルとAI評価者パネルが、リーダーシップ向けの状況判断テストの同じ96の対応の選択肢を評価し、9,433件の実際の受検データをすべてのキーで再採点しました。AI評価者パネルの評価は専門家の評価と.84の相関を示しますが、5段階尺度で0.57ポイント厳しく、パネル内の一致度も過度に高いため、採点キーはその両方を補正するよう調整されています。パネルのキーで採点したテストは、専門家のキーで採点したものと同等の内的整合性を持ち、その項目は、男性と女性、年齢の高い候補者と低い候補者、そして民族集団の違いを問わず同じように機能します。

採点キー研究を読む テスト全体の構築方法

公表済みの研究が示すこと

302件の研究、244,257人を対象とした2026年のメタ分析(Lievensら、Journal of Applied Psychology)は、状況判断テストが職務パフォーマンス(ρ = .23)、組織市民行動(.26)、非生産的職務行動(.35)を予測し、認知能力テストやパーソナリティ検査に予測力を上乗せすることを示しました。動画のシーンはテキストと同等の予測力を持ち、認知的負荷はより低いものでした。候補者自身の言葉による回答は多肢選択式と同等の予測力を持ち、カメラで録画した回答はあらゆる形式の中で最も認知的負荷が低く、著者らはこれが民族サブグループ間の差の縮小につながる見込みがあると述べています。妥当性は研究サンプルよりも実際の応募者(.29)で高く、コーチングや回答の偽装(フェイキング)がこれらのテストを損なうことはないようです。同じ論文は、カスタマイズされた状況判断テストの費用が既製の認知能力テストの約24倍にのぼることも報告しています。このページの動画シーンと対応の選択肢の評価は、これらの知見に沿ったものです。

Lievens, F., Zhou, Y., Ng, J. W. X., Xi, L., Tian, Y., Sackett, P. R., and Martin-Raugh, M. (2026). A meta-analytic examination of the criterion-related validity and cognitive loading associated with traditional and new situational judgment test paradigms. Journal of Applied Psychology. doi:10.1037/apl0001420

貴社にとって何が変わるか

内定後の想定外が、双方で減る。

内定後の想定外が減る

実際の仕事を内側から見た候補者は、自分が何に「はい」と答えているのかを理解しています。入社2か月目に辞めていたであろう人は、選考の途中で自ら身を引く傾向があります。

採用マネージャーが納得する

シーンは現場の人たち自身の状況を、その人たちの言葉で描いたものです。そのため、貴社の職務そのもののスコアは、汎用的なテストのスコアとは違う会話を生み、マネージャーはそれをもとに行動します。

根拠を示せる判断

何が良い回答かを決めるのは貴社の専門家です。すべてのシーンについて、どこから生まれたのか、誰が承認したのか、公平性のチェックで何がわかったのかが記録として残ります。

テスト慣れではなく、判断力

回答は、貴社の専門家の意見がどれだけ一致したかで重み付けされます。そのため、専門家の合意に反する回答は候補者にとって減点となり、どっちつかずの回答も得にはなりません。

貴社の職務のために

貴社の状況から、数週間で使えるテストへ。

出発点は、職務記述書、人事評価の記録、実際にその仕事をしている人との対話など、貴社がすでに持っている資料です。そこから実際の状況を抽出し、一文字も書き始める前に職務に求められることと照合します。一つの職務のために構築したテストが既製のテストと同じ費用で済むのは、SJT Studioがあるからです。カスタマイズされた状況判断テストには、従来は約24倍の費用がかかっていました(Lievens et al., 2026)。

第1週

設計図

貴社の資料、職務に求められること、そして何を測定するかを、一文字も書き始める前にすべて合意します。

第2週

シーンと対応の選択肢

シーンと、候補者が評価する対応の選択肢を作成し、その後、読みやすさの水準、バイアス、各選択肢が何を測定しているかを総合的にレビューします。

第3週

採点

何が良い回答かは貴社の専門家が決め、その意見の一致度で重み付けします。候補者の採点、順位付け、不合格の判定をAIモデルが行うことはありません。

第4週

制作・本番稼働

制作、設定、提供を行い、完全なドキュメント一式をお渡しします。

今お使いの環境でそのまま動く

Podium365上で、貴社の採用管理システムの中で、貴社のブランドで提供されます。インストールするものはなく、IT部門が保守するものもありません。

貴社にお願いすること

構築期間中に数回の対話に参加いただく業務の専門家1名と、出来上がったものを読むレビュアー2名です。それ以外はすべて私たちが担います。

毎回、完全なドキュメント

各シーンがどこから生まれたのか、誰が承認したのか、採点はどのように決められたのか、公平性のチェックで何がわかったのか。ほとんどの状況判断テスト(SJT)には付いてこない記録です。ドキュメントには、テストの構築にAIがどのように使われたかも記録され、貴社の候補者をAIモデルが採点していないことが確認できます。採点キーの背景にある手法は、上記の研究で公開されています。

次のステップ

職務記述書を1つお送りください。

私たちがその職務の最初のシーンを作ってお見せしますので、説明を読むのではなく実物をご覧いただけます。